
La centralisation des données regroupe vos informations critiques, CRM, ERP, paiements, dans une couche gouvernée qui devient la référence unique pour piloter votre entreprise. Le bénéfice principal n’est pas technique : c’est du temps gagné sur le reporting et des chiffres enfin fiables pour décider. Un projet pilote bien cadré peut produire des résultats visibles en trois mois, sans réorganiser tout votre système d’information.
En bref:
- La centralisation des données permet un reporting plus rapide et fiable, avec des gains de temps visibles dès trois mois en réalisant un pilote ciblé.
- Il est essentiel de distinguer centralisation, agrégation et virtualisation pour choisir la solution la plus adaptée à une PME avec plusieurs outils.
- La gestion technique repose sur trois couches : ingestion, stockage (entrepôt ou lakehouse), et consommation via outils de visualisation, en privilégiant l’approche ELT.
- La gouvernance doit reposer sur des rôles précis, des règles claires, et une conformité réglementaire renforcée par ISO 27001 et RGPD, pour éviter de fausses impressions de fiabilité.
- Commencer petit sur un cas prioritaire permet d’éviter l’échec d’un projet trop ambitieux et facilite l’adhésion des équipes.
Table des matières
- Qu’est-ce que la centralisation des données, concrètement ?
- Quels bénéfices concrets attendre, et comment calculer le retour sur investissement ?
- Quelle architecture technique adopter pour centraliser vos données ?
- Comment organiser la gouvernance, la sécurité et la conformité ?
- Quelles étapes suivre pour démarrer un projet de centralisation ?
- Quels pièges éviter lors de la centralisation des données ?
- Comment Digitalease-et-vous accompagne les PME sur ce type de projet
- Pourquoi le pragmatisme doit primer sur la technique
- Digitalease-et-vous vous aide à centraliser vos données sans y consacrer six mois
- Sources
- Questions fréquentes
Qu’est-ce que la centralisation des données, concrètement ?
Centraliser vos données ne veut pas dire tout mettre dans un seul logiciel. Cela consiste à créer une couche gouvernée où chaque information critique a une source de référence claire, accessible et traçable. C’est ce que décrit Stripe dans son approche de la gestion centralisée des données : organiser l’information pour garantir cohérence et fiabilité, pas empiler les outils.
Trois notions se confondent souvent et méritent d’être distinguées. La centralisation copie et consolide les données dans un entrepôt unique. L’agrégation additionne des indicateurs sans toucher aux données source. La virtualisation interroge les systèmes existants à la demande, sans dupliquer l’information. Pour une PME, la centralisation reste généralement le choix le plus robuste dès que plusieurs outils doivent parler entre eux durablement.
Les sources à intégrer en priorité sont souvent les mêmes d’une entreprise à l’autre :
- le CRM, pour le suivi commercial et la relation client ;
- l’ERP, pour les stocks, achats et production ;
- les outils de paiement et de facturation ;
- les tableurs Excel qui font encore tourner des processus critiques ;
- les logs applicatifs et les outils marketing.
Un point souvent négligé : définissez qui est le « maître » de chaque donnée. Le CRM reste maître des contacts, l’ERP maître des stocks. La centralisation synchronise ces sources, elle ne les remplace pas toutes.
Quels bénéfices concrets attendre, et comment calculer le retour sur investissement ?
Le gain le plus visible touche le temps de reporting. Des tâches de rapprochement comptable ou de déclaration qui prenaient plusieurs jours peuvent se réduire à quelques minutes une fois les flux automatisés, un changement d’échelle que confirment plusieurs retours d’expérience en PME. La fiabilité des indicateurs suit le même mouvement : quand le chiffre d’affaires ou la valeur vie client provient d’une seule source vérifiée, les décisions commerciales gagnent en justesse.
Conseil de pro : avant de lancer le projet, chronométrez le temps réellement passé chaque mois sur le reporting manuel dans votre équipe. C’est votre point de comparaison pour mesurer le ROI après trois mois.
Salesforce souligne que pour les PME, centraliser les données devient une étape déterminante pour obtenir des indicateurs fiables et automatiser le reporting, avec des effets directs sur la productivité. IBM va dans le même sens : la consolidation des données améliore la prise de décision tout en réduisant le temps et les coûts consacrés au nettoyage manuel des fichiers.
Pour estimer un ROI simple, une méthode suffit dans la plupart des cas :
- comptez les heures mensuelles passées sur la saisie, le rapprochement et le reporting ;
- multipliez par le coût horaire chargé de la personne concernée ;
- comparez ce montant au coût du projet de centralisation, licences et accompagnement inclus.
Cette approche reste approximative, mais elle donne un ordre de grandeur suffisant pour arbitrer.
Quelle architecture technique adopter pour centraliser vos données ?
Trois couches suffisent à structurer un projet de centralisation, même pour une PME de taille modeste. La couche d’ingestion collecte les données via des connecteurs, qu’il s’agisse d’un pipeline Stripe alimentant directement un entrepôt de données ou d’extractions automatisées depuis votre ERP. La couche de stockage héberge ces données dans un système de données centralisé, généralement un entrepôt de données (data warehouse) ou un lakehouse. La couche de consommation rend l’information exploitable via des outils de visualisation ou des tableaux de bord métier.
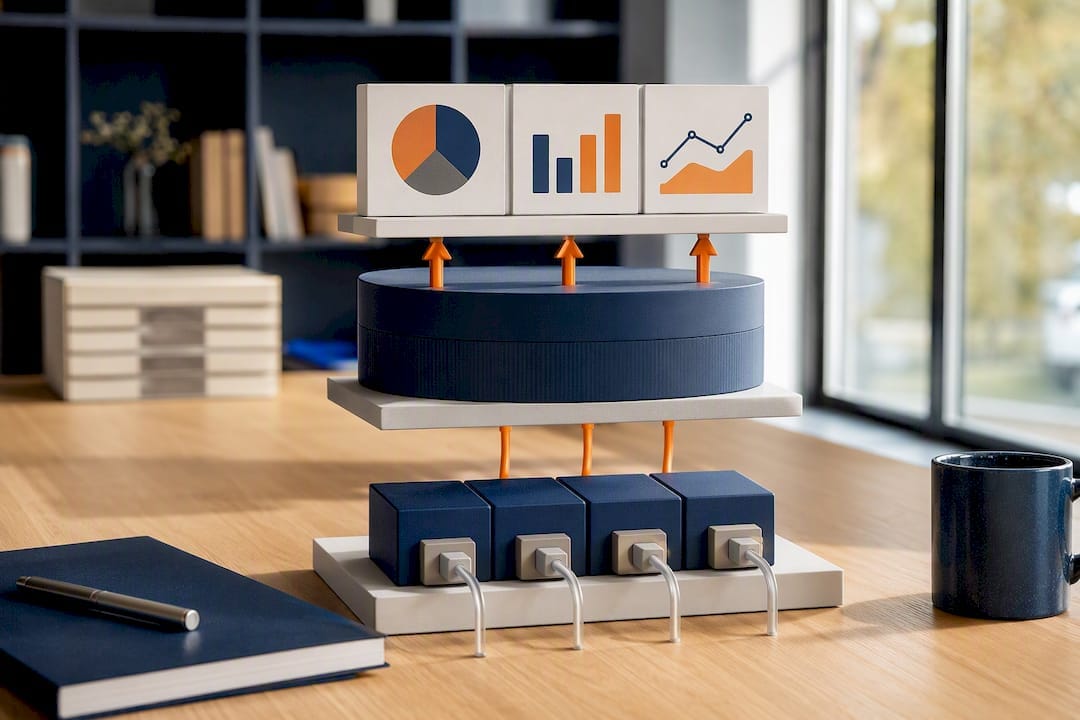
L’approche technique privilégiée aujourd’hui est l’ELT (extraction, chargement, puis transformation) plutôt que l’ETL classique : on charge d’abord les données brutes, puis on les transforme dans l’entrepôt lui-même. Des outils comme dbt permettent de documenter et versionner ces transformations, ce qui facilite la traçabilité, un point que met en avant Stripe dans ses recommandations sur l’architecture de données.
Le choix de l’entrepôt dépend surtout de votre écosystème cloud existant :
- Snowflake convient si vous cherchez une solution agnostique, indépendante de votre fournisseur cloud actuel ;
- BigQuery s’intègre naturellement si vous êtes déjà sur Google Cloud ;
- Redshift reste pertinent pour les entreprises fortement ancrées dans l’écosystème Amazon Web Services.
Aucun de ces trois n’est intrinsèquement supérieur : le critère décisif est votre infrastructure actuelle et le budget mensuel que vous acceptez d’y consacrer.
Comment organiser la gouvernance, la sécurité et la conformité ?
Un entrepôt de données mal gouverné peut créer plus de problèmes que les silos qu’il remplace. C’est l’avertissement que formule Stripe : sans définitions claires ni contrôle qualité, la centralisation donne une fausse impression de fiabilité, ce qui pousse à décider sur des bases erronées avec une confiance renforcée.
La gouvernance repose sur des rôles précis plutôt que sur des outils. Désignez des data owners, responsables métier de chaque domaine de données, et des data stewards, chargés de la qualité au quotidien. Ces rôles n’exigent pas de recrutement : ils s’ajoutent souvent aux fonctions existantes d’un responsable commercial ou financier.
Quatre pratiques structurent une gouvernance solide :
- des nomenclatures communes pour que « client actif » signifie la même chose partout ;
- des tests de qualité automatisés sur les champs critiques (dates, montants, identifiants) ;
- des contrôles d’accès par rôle, avec journalisation des consultations sensibles ;
- un chiffrement systématique des données au repos et en transit.
Sur le plan réglementaire, le RGPD reste le socle pour toute donnée personnelle traitée en Europe. La norme ISO 27001 fournit un cadre reconnu pour structurer un système de management de la sécurité de l’information, utile même sans certification formelle. La directive européenne NIS2 renforce par ailleurs les exigences de cybersécurité pour les opérateurs de services jugés essentiels, un cadre à surveiller si votre secteur y est soumis.
Conseil de pro : nommez un data owner par domaine dès la phase de cadrage, pas après le déploiement. Une gouvernance décidée après coup se heurte presque toujours à des résistances qu’on aurait pu éviter.
Quelles étapes suivre pour démarrer un projet de centralisation ?
Un projet de centralisation réussi avance par phases courtes plutôt que par un big bang technique. Voici la séquence qui fonctionne dans la plupart des PME :
- Cadrage : définissez l’objectif business précis et les indicateurs clés que vous voulez fiabiliser (marge, taux de conversion, délai de paiement).
- Inventaire et nettoyage : listez vos sources de données, identifiez les doublons et les champs incohérents avant toute migration.
- Projet pilote (POC) : concentrez l’effort sur un seul cas d’usage à fort ROI, souvent financier ou commercial, pour valider l’architecture sur un périmètre restreint.
- Industrialisation : étendez le périmètre, construisez la couche sémantique qui traduit les données techniques en indicateurs métier compréhensibles, formez les équipes et suivez les résultats.
Cette logique de phasage rejoint une recommandation partagée par plusieurs cabinets spécialisés dans la stratégie data pour PME : commencer petit, sur un périmètre restreint, permet d’établir la confiance interne avant d’élargir le projet.
Quels pièges éviter lors de la centralisation des données ?
L’erreur la plus fréquente consiste à vouloir tout centraliser d’un coup, un chantier qui s’enlise avant de produire le moindre résultat visible. Les PME qui réussissent commencent petit et démontrent un gain concret avant d’étendre le projet.
Quelques règles limitent les faux départs :
- nettoyez vos données avant de les migrer, jamais après : un entrepôt alimenté par des données sales reste sale ;
- documentez chaque définition et chaque transformation, même sommairement, pour que l’information reste compréhensible dans six mois ;
- impliquez les équipes opérationnelles dès le cadrage plutôt que de leur imposer l’outil une fois construit ;
- montrez un gain rapide et visible, même modeste, pour créer l’adhésion avant d’attaquer les chantiers plus complexes.
L’adoption dépend autant de la gouvernance et de l’implication du terrain que de la qualité technique du système choisi.
Comment Digitalease-et-vous accompagne les PME sur ce type de projet
Notre méthode suit une logique en six étapes : cadrage des objectifs, inventaire des sources, définition de la gouvernance (data owners, règles de qualité), POC sur un cas prioritaire, déploiement progressif, puis formation des équipes. Nous l’avons appliquée notamment lors d’un projet de digitalisation de processus papier chez un client industriel, avec des gains de temps mesurables sur le suivi administratif, un cas détaillé dans nos retours d’expérience clients.
Sur le terrain, trois points reviennent systématiquement :
- le budget varie fortement selon le périmètre retenu, d’où l’intérêt de démarrer par un POC limité ;
- le choix du prestataire technique compte moins que la clarté du cadrage initial ;
- la formation des équipes conditionne l’adoption réelle, bien plus que la sophistication de l’outil.
Pourquoi le pragmatisme doit primer sur la technique
La tentation, face à un projet de centralisation, est de vouloir construire l’architecture parfaite avant de commencer. C’est l’inverse qui fonctionne. Un POC rapide sur un seul cas d’usage à fort ROI vous en apprend plus en trois mois qu’un an de cadrage théorique. La complexité inutile est le principal facteur d’échec que je constate : mesurez les gains à six mois, pas la sophistication de l’outil.
— Vincent
Digitalease-et-vous vous aide à centraliser vos données sans y consacrer six mois
Contrairement à un projet mené en interne sans méthode, ou à l’achat d’un outil sur étagère qui promet tout et cadre rien, un cabinet de conseil peut intervenir comme copilote indépendant : diagnostic des sources de données, POC ciblé sur le cas le plus rentable, puis déploiement progressif avec accompagnement au changement pour que les équipes adoptent réellement le système. Cette approche par phases, détaillée dans notre guide pratique de l’automatisation des processus, limite le risque financier et produit des résultats visibles avant d’étendre le périmètre. Le financement peut, selon votre situation, être pris en charge partiellement via des dispositifs OPCO ou des aides publiques à la transformation numérique. Pour évaluer où commencer, contactez notre équipe et cadrons ensemble votre premier cas d’usage.
Sources
- Solutions de gestion centralisée des données pour les entreprises | Stripe
- Qu’est‑ce que la consolidation des données ? | IBM
- Iso
- NIS2 directive | European Commission digital strategy
Questions fréquentes
Qu’est-ce que la centralisation des données ?
C’est le regroupement des informations critiques d’une entreprise, issues du CRM, de l’ERP ou des paiements, dans une couche gouvernée qui devient la source unique de vérité pour le reporting et la décision.
Quels sont les principes essentiels de la sécurisation des données ?
Trois piliers structurent la sécurité de l’information : la confidentialité (accès restreint aux personnes autorisées), l’intégrité (données non altérées) et la disponibilité (accès garanti quand nécessaire), un cadre repris par la norme ISO 27001.
Quels types de bases de données peut-on centraliser ?
On distingue généralement les bases relationnelles (structurées en tables), les bases NoSQL (documents, clés-valeurs), les bases orientées graphe et les entrepôts analytiques comme Snowflake, BigQuery ou Redshift, chacun adapté à un usage différent.
Quelle différence entre données structurées et non structurées ?
Les données structurées suivent un format fixe et prévisible, comme les lignes d’un tableur ou d’une base CRM. Les données non structurées, comme les e-mails ou les logs, n’ont pas de format uniforme et demandent un traitement spécifique avant d’être exploitées dans un système de données centralisé.
Combien de temps faut-il pour centraliser ses données quand on est une PME ?
Un projet pilote ciblé sur un cas d’usage prioritaire peut produire des résultats mesurables en trois mois. L’industrialisation complète sur plusieurs domaines métier prend généralement plusieurs mois supplémentaires, selon le nombre de sources à intégrer.
Recommandations
- Commencez petit : gouvernance des données pour PME en 6 étapes
- Pourquoi adopter le cloud : guide décideur pour PME
- Pourquoi adopter l’analyse de données en PME
- Qu’est-ce que la data intelligence pour les PME ?
Cet article est co-rédigé avec l’IA et vérifié avant publication.